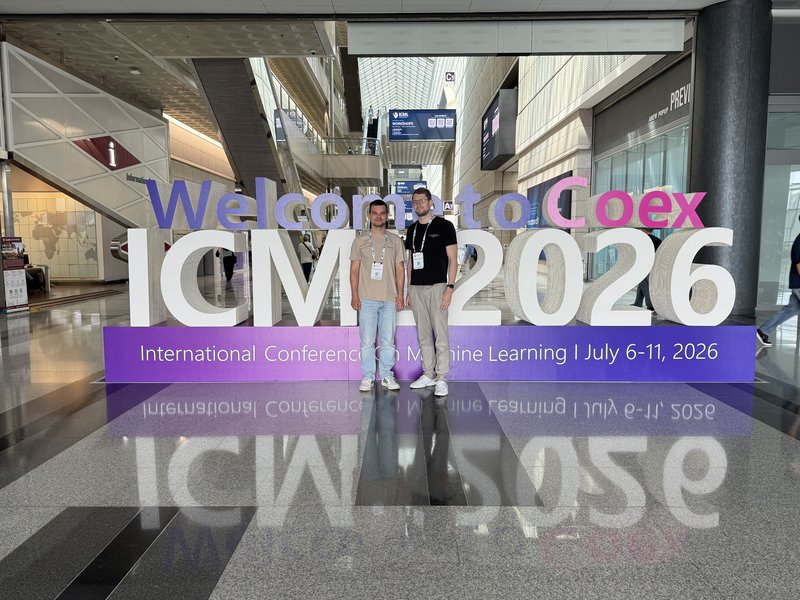
Tobias Schmähling und Marin Wenzel präsentierte unsere neuesten Forschungsergebnisse auf einer der international renommiertesten KI-Konferenzen: der ICML in Seoul. Dort haben wir LIFT vorgestellt, eine neue Methode zur Datenaugmentierung für Offline Reinforcement Learning (RL) in aktiven Positionierungsproblemen.
Im Offline RL hängt die Qualität der gelernten Agenten stark von der Qualität der zugrunde liegenden Daten ab. In der Praxis werden diese Daten häufig von klassischen Regelungsalgorithmen erzeugt, die ihr Ziel in vielen kleinen, stark strukturierten Schritten erreichen. Genau solche Datensätze sind für Offline RL besonders schwierig: Die Trajektorien sind lang und gleichförmig, sodass die Agenten nur langsam und wenig robust lernen.
LIFT setzt auf der Ebene ganzer Trajektorien an: Mehrere aufeinanderfolgende Aktionen werden zu einer einzelnen, größeren Shortcutaktion zusammengefasst. In einer idealen Welt führt die Summe dieser Aktionen exakt zum selben Zustand. In der Realität sorgen jedoch Verzerrungen dafür, dass die Abkürzung nicht immer punktgenau landet. Unser Beitrag beantwortet daher, sowohl theoretisch als auch experimentell, die zentrale Frage, wann eine solche Abkürzung trotzdem nützlich ist. Wir geben eine Bedingung an, unter der ein Shortcut die Strategie verbessert, und zeigen, dass die Strategie nie schlechter wird, wenn Shortcuts ausschließlich dort angewendet werden, wo diese Bedingung erfüllt ist.
In den Experimenten verbessert LIFT die Qualität und Vielfalt der Daten und damit das nachgelagerte Training im Offline RL deutlich, und das über verschiedene Szenarien hinweg. Gleichzeitig zeigt unsere Arbeit auch die Grenzen des Ansatzes auf: Wird die Verzerrung zu stark oder unbeschränkt, verschwindet der Nutzen der Abkürzungen. Unsere Theorie erklärt dabei genau, warum das so ist, und schafft damit eine Grundlage, um Datenaugmentierung für Offline RL gezielt weiterzuentwickeln.
Referenzen:
Code & Dokumentation: github.com/HS-Kempten/lift